ロボットの強化学習とは?仕組み・主なアルゴリズム(PPO・SAC)・報酬設計・実機での活用を解説
ロボットの強化学習とは?仕組み・主なアルゴリズム(PPO・SAC)・報酬設計・実機での活用を解説【2026年版】
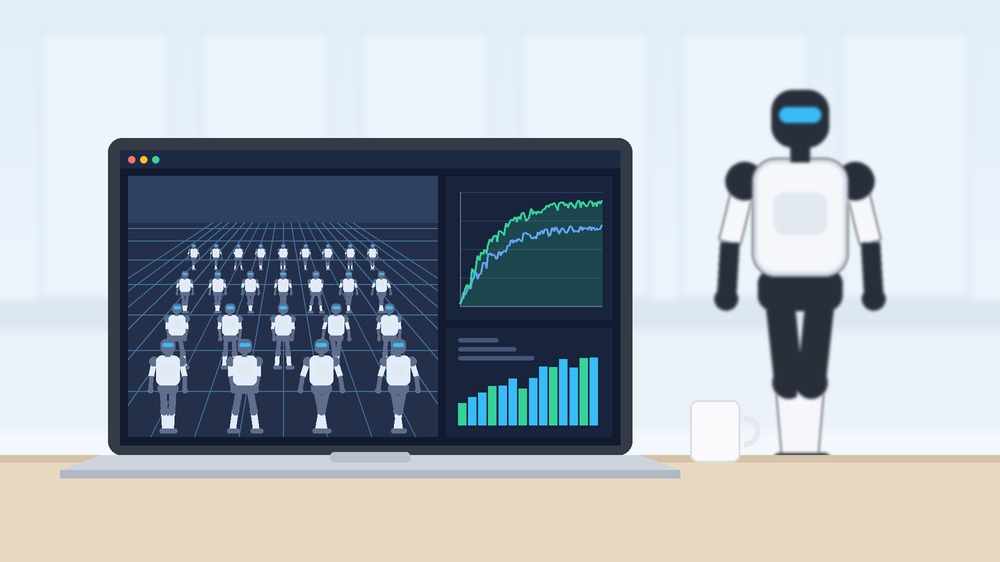
ロボットに「歩く」「転んでも起き上がる」といった動作を覚えさせたいとき、関節の動かし方を人がすべてプログラムで書くのは大変です。そこで使われているのが「強化学習(Reinforcement Learning)」です。ロボットが自分で試行錯誤をくり返し、うまくいった動き方を少しずつ身につけていく——この方法は、ヒューマノイドや四足歩行ロボットの歩行など、フィジカルAI(身体を持つAI)の研究・開発で中心的な技術になっています。
この記事では、ロボットの強化学習の仕組みから、主なアルゴリズム(DQN・PPO・SAC)、成果を左右する報酬の設計、代表的な研究例、学習に使うツール、そしてヴイストンでの取り組みまでをわかりやすく解説します。
この記事でわかること
- 強化学習の仕組み(エージェント・環境・状態・行動・報酬・方策)
- ロボットで強化学習が使われる理由と、その課題
- 主なアルゴリズム(DQN・PPO・SAC)の違い
- 報酬設計のポイントと、よくある失敗
- 学習に使う主なツール(Isaac Lab・RSL-RL・Stable-Baselines3 など)
- 実機で動かすまでの流れと、ヴイストンでの取り組み
強化学習とは?
強化学習とは、ロボットやAI(エージェント)が、環境の中で行動をくり返し、得られる「報酬」がなるべく大きくなるような行動の選び方を、試行錯誤で学ぶ方法です。
人がお手本を見せる「模倣学習」とは違い、強化学習では正解の動きを教えません。そのかわりに、「よい結果には高い点数(報酬)、悪い結果には低い点数」というルールだけを決めておき、どう動けば点数が上がるかを、ロボット自身に見つけさせます。
強化学習の基本の言葉
ロボットの「歩行」を例に、強化学習でよく使う言葉をまとめます。
| 言葉 | 意味 | 歩行ロボットの例 |
|---|---|---|
| エージェント | 学習して行動する主体 | ロボット(の制御プログラム) |
| 環境 | エージェントが行動する世界 | 床や重力のある空間(シミュレーション内または現実) |
| 状態(観測) | エージェントが受け取る、今の状況の情報 | 関節の角度・速度、体の傾き(IMU)、指示された進む速さ |
| 行動 | エージェントが選ぶ動き | 各関節のモーターへの指令(目標角度など) |
| 報酬 | 行動の結果に対する点数 | 指示どおりの速さで進めたら+、転んだら− |
| 方策(ポリシー) | 「この状態ならこう動く」という行動の選び方 | 学習で作られるニューラルネットワーク |
学習の流れは、「状態を見る → 方策にしたがって行動する → 報酬を受け取る → 方策を少し良くする」のくり返しです。これを何百万回もくり返すことで、だんだん上手に歩けるようになります。
👉 強化学習と模倣学習の違いについては、ロボットの模倣学習とは?仕組み・主な手法・強化学習との違い・実機での活用を解説 をご覧ください。
🤖 強化学習で作った動作を「実機で」動かしたい方へ
ヴイストンは、Unitree G1 などのヒューマノイドや、自社開発のロボットの実機を用いて、強化学習・模倣学習による動作開発に取り組んでいます。シミュレーションでの学習から、実機で動かして検証するところまで、ハードとソフトの両面からご相談いただけます。
フィジカルAI開発・実装支援の詳細を見る →
なぜロボットで強化学習が使われるのか
- 動作をプログラムで書きにくい:二足歩行のように、たくさんの関節を同時に、バランスをとりながら動かす制御は、人がルールとして書き下すのが難しい
- 人が思いつかない動き方を見つけられる:試行錯誤の中で、人が手で作った動きより速い・安定した動き方が見つかることがある
- さまざまな状況に対応しやすい:凸凹の地面や押される外乱など、多様な条件で学習させることで、変化に強い動きを身につけられる
- シミュレーションで大量に試せる:GPUを使ったシミュレーションの進化で、何千台ぶんの試行錯誤を同時に行えるようになった
強化学習の主なアルゴリズム
強化学習のアルゴリズムは、大きく3つのタイプに分けられます。
- 価値ベース:「この状態でこの行動をとると、将来どれくらい報酬がもらえるか(価値)」を学び、価値が一番高い行動を選ぶ
- 方策ベース:行動の選び方(方策)そのものを、直接学ぶ
- Actor-Critic(アクター・クリティック):行動を選ぶ役(Actor)と、その行動を評価する役(Critic)を組み合わせて学ぶ
代表的なアルゴリズムを比べると、次のようになります。
| ゴリズム | タイプ | 特徴 | ロボットでの使われ方 |
|---|---|---|---|
| DQN | 価値ベース | ディープラーニングと強化学習を組み合わせ、画面の画像だけからAtariのゲームを学習して注目された | 「右・左・ジャンプ」のような選択肢の決まった行動向き。関節の角度のような連続した値の行動には、そのままでは向かない |
| PPO | 方策ベース(Actor-Critic) | 方策を一度に大きく変えすぎないよう工夫した手法。実装が比較的シンプルで、学習が安定しやすい | シミュレーションでの歩行学習でよく使われる。ロボット向けの学習ライブラリ RSL-RL も、PPOを中心に提供している |
| SAC | Actor-Critic | 過去に集めたデータを再利用しながら学ぶ(オフポリシー)。報酬に加えて「行動のばらつき(エントロピー)」も大きく保つよう学ぶ | 連続した値の行動に強い。集めたデータを使い回せるので、試行回数を抑えたい場面で選ばれる |
※「オンポリシー」は今の方策で集めたデータだけで学ぶ方法、「オフポリシー」は過去に集めたデータも使い回して学ぶ方法です。PPOはオンポリシー、SACはオフポリシーです。
迷ったら、シミュレーションで大量に試せるならPPO、という選び方が一般的です。
報酬設計のポイント
強化学習の成果を大きく左右するのが、報酬の設計です。ロボットは「報酬が大きくなる動き」を覚えるので、報酬の決め方しだいで、できあがる動きがまったく変わります。
歩行ロボットの報酬の例
| 報酬の項目 | ねらい |
|---|---|
| 指示した速さ・向きで進めたら+ | 目的の動き(歩く)を覚えさせる |
| 体の傾きが小さければ+ | 安定した姿勢を保たせる |
| モーターの力(トルク)や動きの急な変化に− | エネルギーを抑え、実機に負担の少ない、なめらかな動きにする |
| 関節が動ける範囲の限界に近づいたら− | 機体を傷めない動きにする |
| 転倒したら−(その回の試行を終了) | 転ばない動きを優先させる |
実際には、こうした項目に重みをつけて足し合わせ、学習の結果を見ながら重みを調整していきます。
よくある失敗:報酬の「抜け道」
報酬の設計が甘いと、ロボットが人の意図とは違う方法で報酬を稼ぐことがあります。これは「報酬ハッキング(Reward Hacking)」と呼ばれ、AIの安全性を扱った研究でも、取り組むべき課題のひとつとして挙げられています。
たとえば「前に進んだ距離」だけを報酬にすると、歩くかわりに前へ倒れ込んだり、実機では壊れてしまうような激しい動きで進んだりする動作を覚えてしまうことがあります。報酬は1つの項目だけに頼らず、姿勢・エネルギー・安全などの項目を組み合わせるのが基本です。
ロボットで強化学習を使うときの課題
- たくさんの試行錯誤が必要:上手に動けるようになるまでに、膨大な回数の試行が必要です。実機だけで学習させるのは、時間的にも現実的ではありません
- 実機が壊れるおそれ:学習の初めは、でたらめに近い動きをします。実機で試すと、転倒や衝突で機体が壊れるおそれがあります
- 報酬設計の難しさ:前の章のとおり、意図した動きを覚えさせるには、報酬の工夫と調整が欠かせません
- シミュレーションと実機のずれ:そこで、シミュレーションで学習してから実機に移すのが一般的です。ただし、シミュレーションと現実には「ずれ」があり、そのままでは実機でうまく動かないことがあります
👉 シミュレーションで学習した動作を実機に移す方法と、ずれの埋め方については、Sim2Realとは?シミュレーションから実機へ|リアリティギャップの原因と埋め方・主なシミュレーターを解説 をご覧ください。
強化学習の代表的な研究例
等身大ヒューマノイドの屋外歩行(カリフォルニア大学バークレー校)
カリフォルニア大学バークレー校の研究チームは、等身大のヒューマノイド「Digit」の歩行を、すべて学習ベースの制御で実現しました。制御には、過去の観測と行動の履歴から次の行動を予測するTransformerのモデルを使っています。条件をランダムに変えた多数のシミュレーション環境で大規模な強化学習を行い、実機での追加学習なしで現実のロボットに移しました。実機のDigitは、さまざまな屋外の地面を歩き、外から押されても倒れずに歩き続けられたと報告されています。
▶ 出典:Radosavovic ほか “Real-world humanoid locomotion with reinforcement learning”(Science Robotics, 2024)
小型ヒューマノイドのサッカー(Google DeepMind)
Google DeepMindの研究チームは、20個の関節を動かせる小型ヒューマノイドに、1対1のサッカーを強化学習で覚えさせました。ロボットは、転倒からの素早い起き上がり、歩く、向きを変える、ボールを蹴るといった動きを身につけ、それらをなめらかにつなげられるようになりました。こちらもシミュレーションだけで学習し、実機での追加学習なしで現実のロボットに移しています。人が手で作った動作と比べて、歩く速さは181%、向きを変える速さは302%向上し、起き上がりにかかる時間は63%短く、ボールを蹴る速さは34%向上したと報告されています。
※ 各研究の詳しい条件や数値は、原論文をご確認ください。
どちらの研究も、シミュレーションで条件をランダムに変えながら学習し、実機に移すという流れです。強化学習とSim2Realは、セットで使われることが多い技術です。
強化学習に使う主なツール
| ツール | 開発元 | 特徴 | ライセンス |
|---|---|---|---|
| Isaac Lab | NVIDIA | GPUで多数のロボットを同時に動かして学習できるフレームワーク。RSL-RL・SKRL・RL Games・Stable-Baselines3 などの学習ライブラリと組み合わせて使える | BSD-3(Isaac Simを使う場合は、その部品のライセンスも確認) |
| RSL-RL | ETHチューリッヒ・NVIDIA | ロボット研究向けの、GPUで高速に学習できる軽量な学習ライブラリ。PPOなどを提供。Isaac Lab などで使われている | BSD系(オープンソース) |
| Stable-Baselines3 | DLR(ドイツ航空宇宙センター)ほか | PPO・SAC・DQNなど、主なアルゴリズムの信頼できる実装をPyTorchでまとめたライブラリ | MIT |
| Gymnasium | Farama Foundation | 学習アルゴリズムと環境をつなぐ「共通の約束ごと(API)」と、練習用の環境をそろえたライブラリ。OpenAI Gymの後継 | MIT |
| unitree_rl_lab | Unitree Robotics | Isaac Labの上に作られた、Unitree製ロボット(Go2・H1・G1)向けの強化学習の環境 | Apache 2.0(READMEの表記) |
ヒューマノイドや四足歩行ロボットの歩行を学習させるなら、Isaac Lab + RSL-RL(PPO)の組み合わせがよく使われます。強化学習を初めて試すなら、Gymnasiumの練習用の環境とStable-Baselines3で、仕組みをつかむところから始めるのがおすすめです。
※ 機能やライセンスは更新されることがあります。使う前に、各公式サイトで最新の情報をご確認ください。
強化学習で実機を動かすまでの流れ
ステップ1:タスクと「状態・行動」を決める
何をさせたいか(例:指示した速さで歩く)を決め、ロボットが受け取る情報(状態)と、出す指令(行動)を決めます。実機のセンサーで実際に取れる情報だけを使うのがポイントです。
ステップ2:報酬を設計する
目的の動き・姿勢・エネルギー・安全などの項目を組み合わせて、報酬を作ります。
ステップ3:シミュレーションで学習する
Isaac Lab などで、たくさんのロボットを同時に動かして学習させます。実機とのずれに備えて、摩擦や質量などの条件をランダムに変えておきます(ドメインランダマイゼーション)。
ステップ4:学習の結果を確かめる
報酬の推移と、実際の動きを見て、意図どおりの動きか(報酬の抜け道を使っていないか)を確認し、必要なら報酬を直して学習し直します。
ステップ5:実機で検証する
別のシミュレーターでも確認(Sim2Sim)したうえで、実機に移します。安全を確保しながら、段階的に試すのが基本です。実機で見つかったずれは、シミュレーションや報酬に反映して、もう一度学習します。
模倣学習との組み合わせ
強化学習と模倣学習は、対立するものではありません。たとえば、
- 模倣学習で人らしい基本の動きを覚えさせ、強化学習で磨き込む
- 強化学習の報酬に「お手本の動きに近いほど+」という項目を入れて、自然な動きにする
といったように、組み合わせて使われることも多くあります。報酬だけでは「人らしい自然な動き」になりにくい場面で、お手本の動きが役に立ちます。
👉 ヒューマノイドの研究で、強化学習・模倣学習がどう使われているかについては、ヒューマノイドロボットとは?Unitree G1・Booster K1など注目機種の特徴・研究活用を解説 をご覧ください。
🤖 「学習はできたのに、実機でうまく歩かない」とお悩みの方へ
シミュレーションで学習した動作を実機で動かし、ずれを確かめながら調整するところまで、ご相談いただけます。報酬設計や学習環境づくりから、ロボットの機構・センサーの追加まで、ハードとソフトの両面で対応します。構想・PoC段階からで大丈夫です。
フィジカルAI開発・実装支援の詳細を見る →
ヴイストンの強化学習・フィジカルAI開発支援
Unitree G1の歩行を、Isaac Labで学習して実機で動かしました
ヴイストンでは、ヒューマノイド「Unitree G1」の歩行を、Isaac Lab を使ってシミュレーションの中で強化学習させ、その結果を実機のG1で動かす取り組みを行いました。この記事で紹介した「シミュレーションで学習 → 結果の確認 → 実機で検証」という流れを、実際のヒューマノイドで進めています。
研究・開発に使えるロボット

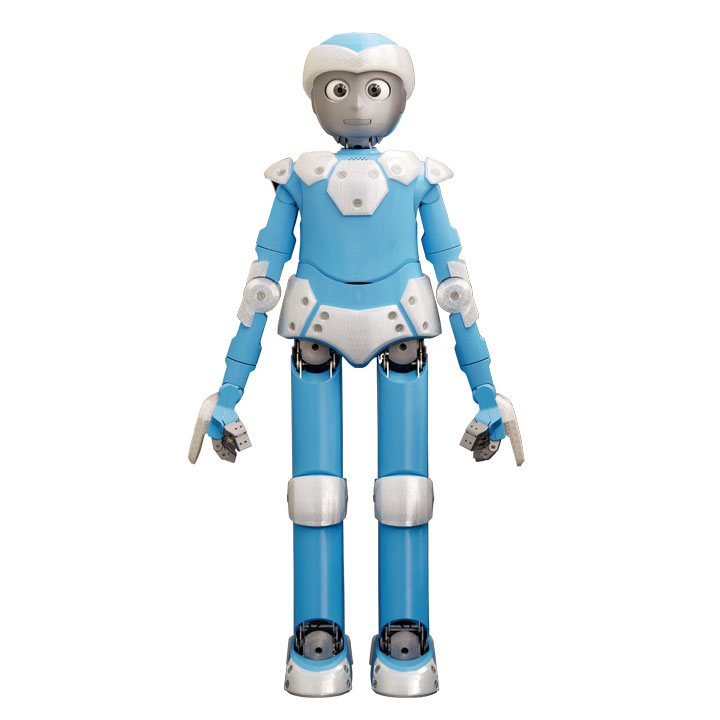
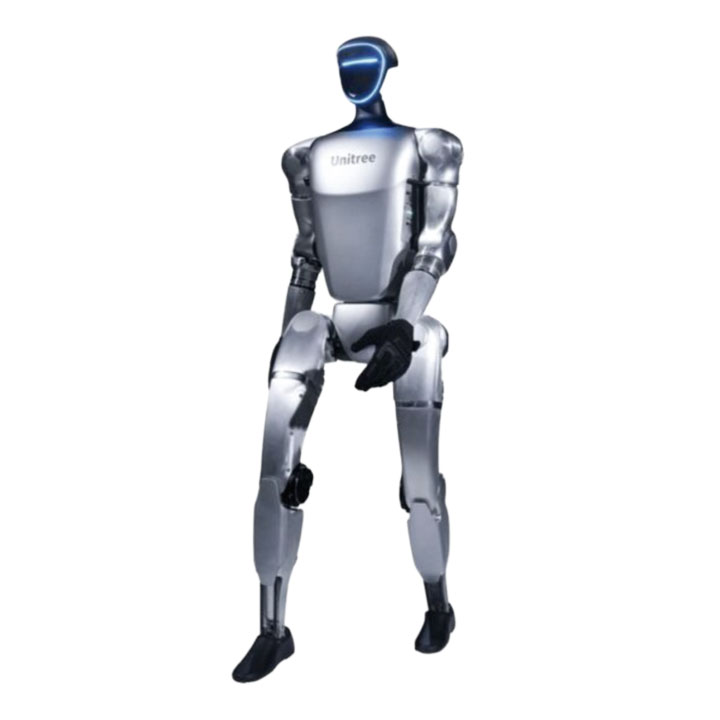
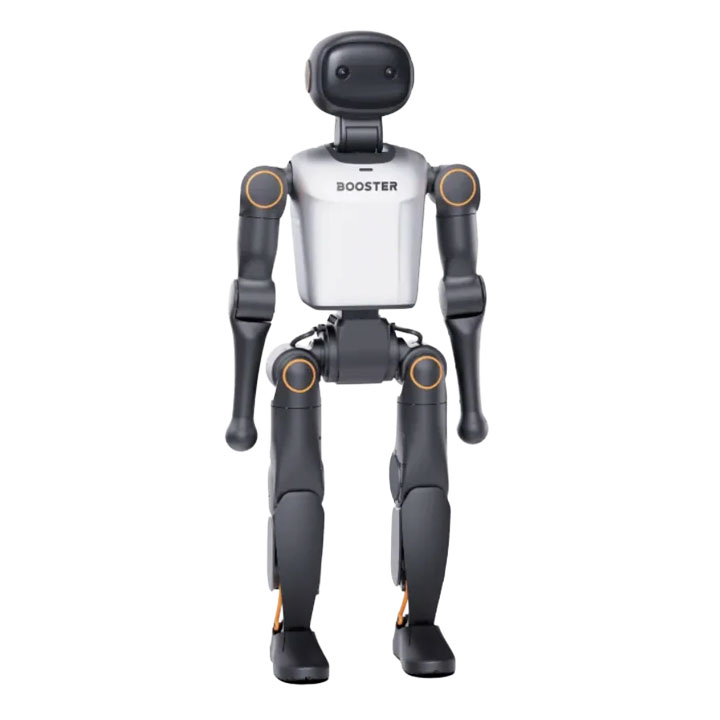
「シミュレーションでは歩けるのに、実機で歩かない」「報酬の設計がうまくいかない」「学習した動作を試す実機がない」といったご相談にも、ハードとソフトの両面から対応します。
👉 対応しているロボットや開発の流れについては、フィジカルAI開発・実装支援 をご覧ください。
よくあるご質問(FAQ)
Q. ロボットの強化学習とは何ですか?
ロボットが環境の中で行動をくり返し、得られる報酬がなるべく大きくなるような動き方を、試行錯誤で学ぶ方法です。正解の動きを教えるのではなく、「よい結果には高い点数」というルールだけを決めて、動き方をロボット自身に見つけさせます。
Q. 強化学習と模倣学習はどう違いますか?
模倣学習は人のお手本から学ぶのに対し、強化学習はお手本なしで、報酬をもとに試行錯誤で学びます。模倣学習で基本の動きを覚えさせ、強化学習で磨き込むなど、組み合わせて使うことも多くあります。
Q. ロボットの強化学習では、どのアルゴリズムがよく使われますか?
シミュレーションで大量に試行できる歩行の学習などでは、PPOがよく使われます。集めたデータを使い回して試行回数を抑えたい場面では、SACが選ばれることもあります。
Q. 報酬はどうやって設計すればよいですか?
目的の動き(例:指示した速さで進む)に加えて、姿勢の安定・エネルギーの少なさ・機体の安全などの項目を組み合わせるのが基本です。1つの項目だけに頼ると、ロボットが意図しない方法で報酬を稼ぐ「報酬ハッキング」が起きやすくなります。
Q. 実機だけで強化学習をすることはできますか?
不可能ではありませんが、膨大な試行回数が必要なうえ、学習の初めは機体が壊れるおそれもあります。そのため、シミュレーションで学習してから実機に移す「Sim2Real」の進め方が一般的です。
Q. 強化学習で作った動作を、実機で動かす相談はできますか?
ご相談いただけます。ヴイストンでは、Unitree G1の歩行をIsaac Labで学習して実機で動かす取り組みを行っており、ヒューマノイドや自社開発ロボットの実機を用いた動作開発・制御実装・評価に取り組んでいます。構想・PoC段階からご相談ください。
まとめ
強化学習は、ロボットが試行錯誤をくり返しながら、報酬が大きくなる動き方を自分で身につける方法です。プログラムで書きにくい歩行や全身の動作を作れるため、ヒューマノイドや四足歩行ロボットを中心に、フィジカルAIの研究・開発で広く使われています。
成果を左右するのは、報酬の設計と、シミュレーションで学習した動作を実機で動かすまでの調整です。PPOなどのアルゴリズムやIsaac Labなどのツールがそろった今、実機で検証し、そのずれをシミュレーションに戻すくり返しが、ますます重要になっています。
ロボットの強化学習やフィジカルAIの研究・開発について、具体的にご検討の際は、お気軽にご相談ください。
💬 強化学習・フィジカルAIの研究開発をご検討の方へ
「シミュレーションでは歩けるのに、実機で歩かない」「報酬の設計がうまくいかない」「どのロボットで試すべきか迷っている」——そんな段階からのご相談で大丈夫です。ヴイストンは、強化学習・模倣学習を用いたロボットの動作開発に取り組んでおり、ハードからソフトまで両面でご支援します。
構想・PoC段階から、エンジニアが課題整理からご提案します。
まずは資料だけ見たい方は ⤓ 資料ダウンロード(PDF・登録不要)
参考文献
- Sutton, R. S., & Barto, A. G. (2018). Reinforcement learning: An introduction (2nd ed.). MIT Press.
- Mnih, V., Kavukcuoglu, K., Silver, D., Rusu, A. A., Veness, J., Bellemare, M. G., … & Hassabis, D. (2015). Human-level control through deep reinforcement learning. Nature, 518(7540), 529–533.
- Schulman, J., Wolski, F., Dhariwal, P., Radford, A., & Klimov, O. (2017). Proximal policy optimization algorithms. arXiv preprint arXiv:1707.06347.
- Haarnoja, T., Zhou, A., Abbeel, P., & Levine, S. (2018). Soft actor-critic: Off-policy maximum entropy deep reinforcement learning with a stochastic actor. arXiv preprint arXiv:1801.01290.
- Amodei, D., Olah, C., Steinhardt, J., Christiano, P., Schulman, J., & Mané, D. (2016). Concrete problems in AI safety. arXiv preprint arXiv:1606.06565.
- Radosavovic, I., Xiao, T., Zhang, B., Darrell, T., Malik, J., & Sreenath, K. (2024). Real-world humanoid locomotion with reinforcement learning. Science Robotics, 9(89), eadi9579.
- Haarnoja, T., Moran, B., Lever, G., Huang, S. H., Tirumala, D., Humplik, J., … & Heess, N. (2024). Learning agile soccer skills for a bipedal robot with deep reinforcement learning. Science Robotics, 9(89), eadi8022.
参考リンク
- Isaac Lab(GitHub):https://github.com/isaac-sim/IsaacLab
- RSL-RL(GitHub):https://github.com/leggedrobotics/rsl_rl
- Stable-Baselines3(GitHub):https://github.com/DLR-RM/stable-baselines3
- Gymnasium(GitHub):https://github.com/Farama-Foundation/Gymnasium
- unitree_rl_lab(GitHub):https://github.com/unitreerobotics/unitree_rl_lab