ロボットの模倣学習とは?仕組み・主な手法・強化学習との違い・実機での活用を解説
ロボットの模倣学習とは?仕組み・主な手法・強化学習との違い・実機での活用を解説【2026年版】
ロボットに複雑な動作を覚えさせたいとき、人が一つひとつプログラムを書くのは大変です。そこで注目されているのが「模倣学習(Imitation Learning)」です。人がお手本を見せ、ロボットがそれを真似て学ぶ——この考え方は、フィジカルAI(身体を持つAI)の研究・開発で中心的な技術のひとつになっています。
この記事では、ロボットの模倣学習とは何かという基本から、主な手法、強化学習との違い、代表的な研究例、そして実機で使うときのポイントまでをわかりやすく解説します。
模倣学習とは?
模倣学習とは、専門家(人)によるお手本(デモンストレーション)をもとに、ロボットやAIが「どう動けばよいか」を学ぶ手法です。英語では Imitation Learning、または Learning from Demonstration と呼ばれます。
お手本は、通常「そのときの状況(観測)」と「そのときにとった行動」のペアとして記録されます。ロボットはこのデータから、「この状況ではこう動く」という規則(方策)を、教師あり学習の形で学びます。
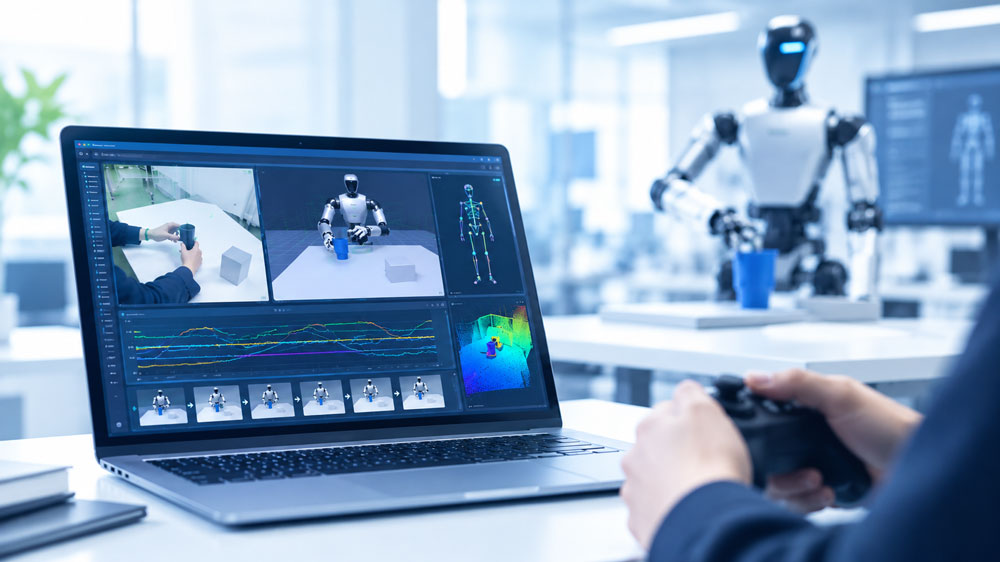
たとえば「机の上のコップをつかんで運ぶ」動作を、人がロボットを操作して何度かやってみせる。そのデータで学習したロボットが、同じ動作を自分で再現できるようになる、というイメージです。
🤖 模倣学習を「実機で」試したい方へ
ヴイストンは、VR遠隔操作に対応したロボットや双腕ロボット、ヒューマノイドの実機を用いて、模倣学習・強化学習による動作開発に取り組んでいます。お手本データの収集から実機での検証まで、ハードとソフトの両面からご相談いただけます。
フィジカルAI開発・実装支援の詳細を見る →
なぜ模倣学習が注目されるのか
- 動作を言葉やコードで書き下すのが難しい:人の手の動きのような複雑な動作は、ルールとして記述しにくい
- お手本を見せるだけで覚えさせられる:専門的なプログラミングが少なくて済む場面がある
- フィジカルAIと相性がよい:実機のロボットに、人らしい動作を持たせやすい
模倣学習の主な手法
模倣学習にはいくつかの代表的な手法があります。
| 手法 | ひとことで言うと |
|---|---|
| 行動クローニング(Behavior Cloning) | お手本の「状況→行動」を、教師あり学習でそのまま真似る。最も基本的な形 |
| DAgger | 学習した方策でロボットを動かし、遭遇した状況に対して専門家が正解の行動を教え、データを追加して再学習することを繰り返す。行動クローニングの弱点を補う手法 |
| GAIL | 敵対的生成ネットワーク(GAN)の考え方を使い、ロボットの振る舞いの分布を専門家のお手本に近づける |
| 逆強化学習(IRL) | お手本の行動を説明できる「報酬」を推定し、その報酬で強化学習して方策を得る |
まず基本となるのは行動クローニングで、実際のロボット研究でも広く使われています。
模倣学習と強化学習の違い
フィジカルAIの文脈では、模倣学習とよく比較されるのが「強化学習」です。
| 模倣学習 | 強化学習 | |
|---|---|---|
| 学び方 | 人のお手本から学ぶ(教師あり学習) | 環境との試行錯誤で、報酬を最大化するよう学ぶ |
| 必要なもの | お手本となるデモデータ | 報酬の設計と、多くの試行錯誤 |
| 向いている場面 | 人の動作を再現したい/動作を書き下しにくい | 明確な目標(報酬)があり、シミュレーションで大量に試せる |
2つは対立するものではなく、組み合わせて使われることも多いのが実際です。たとえば、まず模倣学習で人らしい基本動作を覚えさせ、その後に強化学習で磨き込む、といった使い方です。
👉 強化学習の仕組みやアルゴリズムについては、ロボットの強化学習とは?仕組み・主なアルゴリズム(PPO・SAC)・報酬設計・実機での活用を解説 をご覧ください。
代表的な研究例
ALOHA(低コストの双腕遠隔操作システム)
スタンフォード大学などの研究チームが発表した、低コストな双腕ロボットの遠隔操作システム「ALOHA」と、それを使った学習手法「ACT(Action Chunking with Transformers)」です。人が遠隔操作で見せたお手本から、ロボットが細かな両手作業を学べることを示しました。行動を1つずつではなく、まとまり(チャンク)で予測するのが特徴です。ハードウェアの予算が約2万ドルで、比較的少ないお手本データ(1タスクあたり約50件のデモ)で学習できたと報告されています。
▶プロジェクトページ :https://tonyzhaozh.github.io/aloha/
Diffusion Policy(拡散モデルによる方策学習)
コロンビア大学などの研究チームが発表した、画像生成で知られる拡散モデルの考え方を、ロボットの方策に応用した手法です。複数の動き方がありうる場面(たとえば、物を左から押すか右から押すか)でも、安定して一つの動き方を選べる点などが評価されています。論文では、複数のベンチマークで既存手法を上回る結果が報告されています。
▶プロジェクトページ:https://diffusion-policy.cs.columbia.edu/
※ 各研究の詳細な数値・条件は、原論文をご確認ください。
これらの研究に共通するのは、人が遠隔操作でお手本を見せ、それを学習してロボットが動くという流れです。実機でお手本データを集める環境づくりが、成果を左右します。
模倣学習の課題
模倣学習は強力な一方で、いくつかの課題もあります。
- 分布シフト:学習したロボットが、お手本とは少し違う状況に入り込むと、そこにはお手本データがないため、うまく動けなくなることがある(行動クローニングで特に指摘される課題)
- 誤差の蓄積:小さなズレが時間とともに積み重なり、学習時の状況から外れてしまう
- お手本の量と質:品質の高いデモデータを、一定量そろえる必要がある
- 汎化:お手本と異なる環境や物体にどこまで対応できるか
こうした課題に向き合うには、実機でのデータ収集・検証を繰り返すことが欠かせません。
実機での模倣学習:お手本データをどう集めるか
ロボットでの模倣学習では、人がロボットを遠隔操作し、その動きをお手本データとして記録する方法が代表的です。研究例のALOHAも、専用の遠隔操作インターフェースでお手本を集めています。
実機で取り組む際は、次のような点が重要になります。
- 操作しやすい遠隔操作環境:人が自然に動かせるほど、質の高いお手本データが集まる
- 実機での再現と検証:学習した動作を実機で動かし、うまくいかない場面を見つけて改善する
- シミュレーションとの併用(Sim2Real):仮想環境で作り込み、実機に移して検証する
🤖 「お手本データを集める環境がない」とお悩みの方へ
遠隔操作でのデータ収集環境づくりから、学習した動作を実機で動かして検証するところまで、ご相談いただけます。シミュレーション(Sim2Real)との併用も対応します。構想・PoC段階からで大丈夫です。
フィジカルAI開発・実装支援の詳細を見る →
ヴイストンの模倣学習・フィジカルAI開発支援
ヴイストンでは、模倣学習・強化学習を用いたロボットの動作開発に取り組んでいます。
- VR遠隔操作に対応した二足歩行ロボット「VS-LHR01」:人の動きをリアルタイムでロボットに反映でき、模倣学習向けの動作データ収集に活用できます
- 台車移動型双腕ロボット「VS-MPR-01」:強化学習・模倣学習を用いた動作開発のプラットフォームとして最適で、Sim2Realにも対応します
- Unitree G1・Booster K1 などのヒューマノイドの実機を用いた、モーション開発・制御実装・評価
「お手本データを集める環境がない」「学習した動作を実機で動かせない」といったご相談にも、ハード・ソフトの両面から対応します。 (詳しくは「フィジカルAI開発・実装支援」をご覧ください)
よくあるご質問(FAQ)
Q. 模倣学習とは何ですか?
人のお手本(デモンストレーション)をもとに、ロボットやAIが動作を学ぶ手法です。お手本は「状況」と「行動」のペアで記録され、そこから「この状況ではこう動く」という規則を学びます。
Q. 模倣学習と強化学習はどう違いますか?
模倣学習は人のお手本から学ぶのに対し、強化学習は環境との試行錯誤で報酬を最大化するよう学びます。両者を組み合わせて使うことも多くあります。
Q. ロボットのお手本データは、どうやって集めますか?
人がロボットを遠隔操作し、その動きを記録する方法が代表的です。操作しやすい遠隔操作環境があるほど、質の高いデータが集まります。
Q. 模倣学習を実機で試したいのですが、相談できますか?
可能です。ヴイストンでは、VR遠隔操作に対応したロボットや、双腕ロボット、ヒューマノイドの実機を用いた、動作開発・制御実装・評価をご支援します。構想・PoC段階からご相談いただけます。
まとめ
模倣学習は、人のお手本からロボットが動作を学ぶ手法で、フィジカルAIの中核となる技術です。行動クローニングを基本に、DAgger・GAIL・逆強化学習などの手法があり、強化学習と組み合わせて使われることも多くあります。
一方で、分布シフトやお手本データの質・量といった課題があり、実機でお手本を集め、検証を重ねる環境づくりが成果を左右します。
模倣学習やフィジカルAIの研究・開発について、具体的にご検討の際は、お気軽にご相談ください。
💬 模倣学習・フィジカルAIの研究開発をご検討の方へ
「お手本データの集め方が分からない」「学習した動作を実機で動かせない」「どのロボットで試すべきか迷っている」——そんな段階からのご相談で大丈夫です。ヴイストンは、模倣学習・強化学習を用いたロボットの動作開発に取り組んでおり、ハードからソフトまで両面でご支援します。
構想・PoC段階から、エンジニアが課題整理からご提案します。
📩 翌営業日以内にご返信いたします。
お問い合わせはこちら → フィジカルAI開発・実装支援の詳細を見るまずは資料だけ見たい方は ⤓ 資料ダウンロード(PDF・登録不要)
参考文献
- Zhao, T. Z., Kumar, V., Levine, S., & Finn, C. (2023). Learning fine-grained bimanual manipulation with low-cost hardware. arXiv preprint arXiv:2304.13705.
- Chi, C., Xu, Z., Feng, S., Cousineau, E., Du, Y., Burchfiel, B., … & Song, S. (2025). Diffusion policy: Visuomotor policy learning via action diffusion. The International Journal of Robotics Research, 44(10-11), 1684-1704.